
クロールボットの挙動と対策
数日前に、あるサーバーの1日のトラフィックが普段の2倍近くに跳ね上がったんです。ログを追ってみると、3つの収集ボットが掲示板の画像を丸ごとダウンロードしていたことが判明しました。重い画像のリクエストだけを拒否するように設定を入れ、これで解決したと安堵したんです。ところが、5日後に改めてログをチェックしたとき、実際に何が起こっていたのかを目の当たりにしました。画像はブロックされていたのに、全体のトラフィック量はほとんど減っていないんです。最も多くアクセスしていたボットは、記事を読みながら、同じ記事を何十回も繰り返し読み込んでいる状態でした。
同じコンテンツを何十倍にも増やしてしまうボットの正体
1日のアクセス記録をボットごとに分類して見てみました。リクエスト数だけでは「どのボットがどれだけアクセスしたか」しか分かりませんから、リクエストされたURLを2種類に分けてカウントしたんです。具体的には、クエスチョンマーク(?)以降も含めた完全なURLがいくつあったか、そしてクエスチョンマークを取り除いたパス(ファイル名や階層)だけがいくつあったかを数えました。この2つを比較することで、ボットが同じコンテンツをいくつ異なるURLとして認識しているのかが分かってくるわけです。
| 収集ボット | 総リクエスト数 | ユニークURL数 | ユニークパス数 | パスあたりの平均URL数 |
|---|---|---|---|---|
| GPTBot | 295,616 | 295,042 | 9,542 | 30.9 |
| Amazonbot | 134,681 | 114,042 | 18,009 | 6.3 |
| Googlebot | 59,487 | 30,102 | 15,795 | 1.9 |
| Bingbot | 7,837 | 5,700 | 3,603 | 1.6 |
| AhrefBot | 12,886 | 7,211 | 7,211 | 1.0 |
| ClaudeBot | 6,460 | 4,624 | 4,055 | 1.1 |
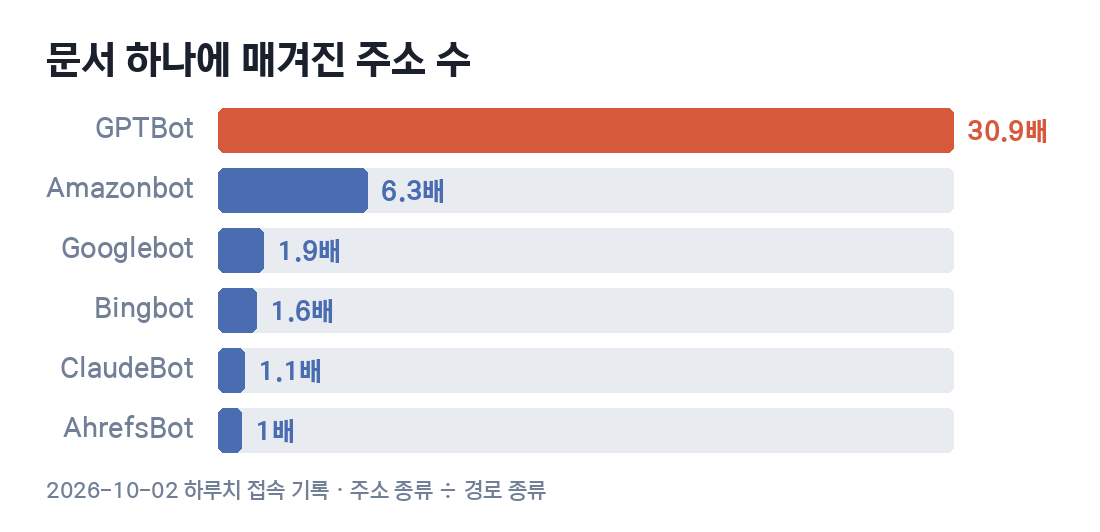
一番上の行が問題でした。実際のドキュメントは9,542個なのに、URLは295,042個に膨れ上がっているのです。ドキュメント一つにつき平均31個のURLを割り当てて、それをすべて別々に取得してしまっていたわけです。リクエスト数で見ると、1日の全リクエスト261万件のうち11.3パーセント、データ量では3.43ギガバイトに達しました。レスポンス一つあたりの平均サイズはわずか12キロバイトですが、リクエスト数が29万件もあったため、それだけのデータが蓄積してしまったのです。
しかも、たった一つのボットがまとめて大量にスクレイピングしたわけではありません。リクエストを発信しているアドレスは231種類にも分かれていました。特定の単一アドレスをブロックするだけでは対応しきれない状況のようです。
名前を明かしたボット6種類を合わせると、1日のリクエストの19.8パーセントを占めており、その大半が一番上の行の要因でした。
同じ日に同じサイトを巡回したClaudeBotは、4,055個のドキュメントを4,624個のURLとして認識していました。これは1.1倍ですね。一方、Ahref sBotは正確に1.0倍でした。同じリンクを見ているはずなのに、片方は1倍、もう片方は31倍という結果です。サイト側から送られてくる情報が同じものであれば、この差は受け取る側がURLをどう解釈するか、という点から生じているのでしょう。
並び替えリンクがURLを増やしてしまう原因
原因は、掲示板のリストページにある並び替えリンクでした。掲示板のリストには、通常「新しい順」や「閲覧数順」といった並び替えボタンがありますよね。このボタンが生成するURLを詳しく見てみると、並び替えの基準だけではなく、現在見ているページ番号、掲示板名、検索条件などがすべてくっついていたんです。
例えば、3ページ目で並び替えボタンを押すと、「閲覧数順で3ページ目を表示する」といったURLが生成されます。もしページが100ページあったら、並び替えのURLも100種類できてしまうわけです。さらに、そのURLにまた並び替えボタンがあり、そのボタンには現在の状態が反映される。リンクを辿っていく側から見ると、どこまで辿っても新しいURLが出てきてしまうんです。
並び替えのパラメータが付加されたリクエストの割合を見ると、ボットごとにその傾向がはっきりと分かります。
| 収集ボット | 並び替え条件が付加されたリクエスト |
|---|---|
| GPTBot | 97.7% |
| Amazonbot | 79.2% |
| Googlebot | 54.1% |
| Bingbot | 17.6% |
| ClaudeBot | 2.0% |
| AhrefスBot | 0.0% |
GPTBotからのリクエストのうち、9割以上で並び替え条件が付加されていました。対照的に、AhrefスBotからは1件も並び替え条件が付加されていませんでした。つまり、彼らは並び替えリンクをそもそも辿っていないということです。
空の条件もURLを増やしてしまう
URLを一つ取り出して詳しく調べてみると、さらに驚くべきことが分かりました。検索ワードの欄や分類の欄が、空の状態でURLに含まれていたのです。検索をしていないので結果は同じに見えても、文字列としては全く異なるURLになってしまうわけです。
人間が見る上では同じ画面に見えるかもしれません。しかし、URLの文字列を比較するシステムから見れば、それは別の文書として認識されてしまうのです。もし空の条件が6つ付加されていた場合、その組み合わせの数だけURLが分岐してしまう可能性があります。並び替えの条件2種類にページ数100を掛け、そこに空の条件の数を掛け合わせると、なんと31倍という数字が出てくるのです。
これは単にボットのせいだけだと断言するのは難しいかもしれません。URLが異なれば、それは別の文書であるかもしれない、という前提が間違っているわけではないからです。ただ、その前提を最後まで信じて辿り続けると、終わりが見えないウェブサイトが存在するわけで、私のサイトもその一つだったわけです。
54,377回もリクエストされたパスワード入力画面について
経路別に転送量を集計したところ、一番多かったのが予想外の場所でした。記事ではなく、パスワード入力を求められる画面だったのです。1日に54,377件、275メガバイトものリクエストがありました。これはGPTBotが取得した全転送量の約8パーセントを占めています。
これは、保護されている記事を修正しようとした際に出てくる画面です。パスワードを知らなければ何も表示されません。Botがパスワードを知るはずがないため、54,377件すべてが同じ入力フォームにアクセスしていたわけです。さらに、ここにも並び順の条件やページ番号が付与されていました。そのため、記事ごと、ページごと、並び順ごとにURLが異なって生成されていたのです。
価値のない情報に対して最も多くアクセスしている、という点が重要です。Botは、その画面がパスワードを求めているのかどうかを判断できません。レスポンスコードが正常で内容が返ってくれば、それを取得してしまうのです。以前「リンクを貼る側と受け取る側では見え方が違う」という話をしましたが、これはBotとサーバーの間でも同じことが起きているのです。
画像をブロックしたことで効果はあったものの…
最初に設定した画像ブロックは確かに機能していました。設定に記載した3つのBotからの掲示板の画像リクエストはすべて拒否されていました。結果として、それらのBotが取得した量はそれぞれ1メガバイト程度にまで減っていました。
しかし、全体の転送量は22.7ギガバイトと、問題が発生する前と比較しても依然として高い状態でした。つまり、画像で外部に出ていた分が、別の場所へ移動した形です。掲示板の画像を最も多く取得していたBotも変わっていました。ブロックリストに入れていなかった検索Botが1.3ギガバイトでトップになっていたのです。これは検索エンジンでの露出が必要だと判断し、意図的に開けておいた部分です。
移動した場所にもう一つ要因がありました。2番多くリクエストを送っていたBotは、リクエストの約39,570件がURLの移動案内を受け取っており、983件は存在しない文書を探していました。これは以前のURLにアクセスしようとしているケースです。サイトの構造を変更した後に残った痕跡をBotが探し続けている状態なので、ここはブロックではなくURLの整理で解決すべき点だと考えます。
また、ブロックリストに載っていなかった他の収集Botも画像フォルダに侵入してきていました。量は3メガバイトと少なかったですが、リスト方式の限界を示しています。名前を登録してブロックする方法は、登録した名前のものにしか効きません。新しいBotが出現するたびに、手動で追加していく必要があるのです。
ブロックするより「作らない」ことが大事だった
5日間かけて二度見した結果、方針を根本から変えるべきだと結論づけました。リクエストを拒否するのは、すでに届いた後の対応に過ぎません。そもそもなぜ29万件ものリクエストが発生するのか、その根本的な原因は変わっていないからです。
| 対応 | 効果 | 限界 |
|---|---|---|
| 名前で拒否する | 送信量がすぐに減る | 記載された名前だけに反応する |
| 収集拒否文書に明記する | リクエスト数が減る | 遵守している側だけに効く |
| 代表アドレスを指定する | 重複を一つのアドレスにまとめる | 追跡しないボットもいる |
| ソートリンクに収集拒否表示 | 組み合わせが発生しない | リンク自体の修正が必要 |
| アドレスから空の条件を除外 | アドレスのバリエーションが減る | リストのコードを修正する必要がある |
上記の二つは外部から施す対策ですが、下の三つはサイト側がアドレスを生成しにくくする対策です。効果を比較すると、後者のほうが断然優れています。なぜなら、ボットが何らかのルールを守ってくれることに依存しないからです。
作業の順番としては、まず「空の条件を除外する」のが最もコストがかかりません。ソートリンクを作成する際に、値が入っていない条件を付与しないようにすれば、それだけで一つの組み合わせが消えます。以前、「人間が自動化を止めるポイント」について調査した際も同様の傾向が見えましたが、後からブロックする仕組みを作るよりも、そもそも問題が発生しないようにする方が手間がかからないと感じました。
この数字を鵜呑みにしないでください
これは一日の記録だけで算出された数字です。ボットは毎日動きを変えるので、翌日の比率は変わる可能性があります。同じボットが数日間にわたって一定の量を維持していると言い切るには、もっと期間を見守る必要があります。
ボットの区別は、リクエストのヘッダーに記載されている名前で分類しています。この値は送信側が自由に設定できるものです。名前を明かさずにブラウザを装ってアクセスしてくる収集機は、この集計には含まれていません。ですから、表の数字は名前を明かしたボットに限定された話だとご理解ください。
また、経路の住所の数が「1に近い」ということが、必ずしも良いボットだということにはなりません。それは単にソートリンクを辿らなかったというだけで、その過程で取得すべきページを見落としている可能性もあります。サーバーにとって負荷が軽いことと、サイトを正しく読み込めていることは別問題です。今回カウントしたのは、あくまで表面的な部分だけですから。